






Ngành công nghiệp bán dẫn toàn cầu đang chứng kiến bước chuyển dịch quan trọng khi Apple chính thức ứng dụng quy trình đóng gói tiên tiến 3D SoIC trên tiến trình 2nm của TSMC cho thế hệ vi xử lý Apple M5. Động thái này đánh dấu chiến lược tách rời khỏi giới hạn vật lý của kiến trúc đóng gói 2D phẳng truyền thống để đạt mật độ bóng bán dẫn chưa từng có.
Kiến trúc xếp chồng 3D SoIC và tối ưu hóa băng thông bộ nhớ
Công nghệ SoIC (System-on-Integrated-Chips) cho phép Apple tích hợp các khuôn tính toán logic và khối bộ nhớ theo chiều dọc với mật độ chân nối siêu nhỏ. Giải pháp này giúp rút ngắn đáng kể khoảng cách truyền dẫn dữ liệu giữa CPU, GPU và Unified Memory, từ đó giảm thiểu độ trễ giao tiếp xuống mức gần như triệt tiêu.
Nhờ cấu trúc vi mô mới, mức tiêu thụ năng lượng trên mỗi phép tính giảm hơn 25%, đồng thời giải quyết triệt để điểm nghẽn nhiệt lượng thường gặp ở các chip SoC đơn khối truyền thống khi tải nặng liên tục trong môi trường máy tính di động.
Nâng tầm xử lý mô hình ngôn ngữ lớn nhờ Neural Accelerator chuyên dụng
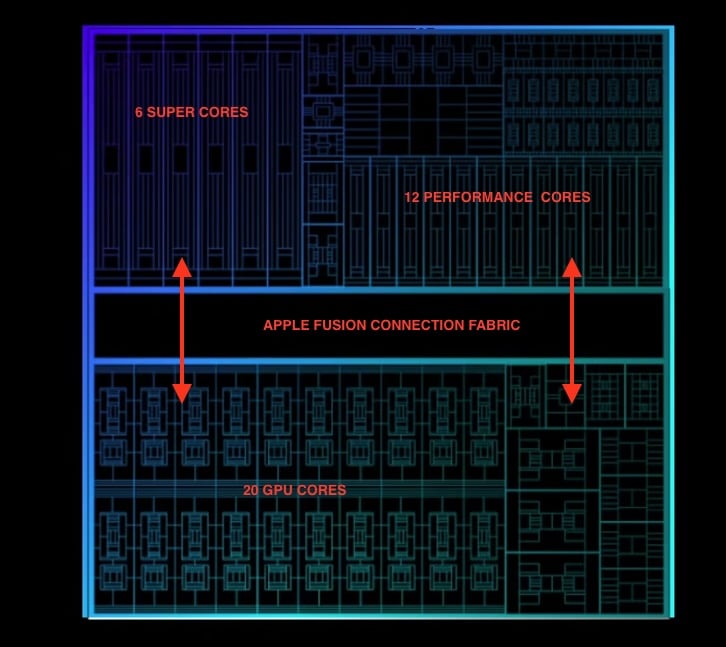
Trọng tâm kỹ thuật của M5 nằm ở cụm Neural Accelerator thế hệ tiếp theo, được thiết kế riêng để tăng tốc các phép toán ma trận trong mạng nơ-ron sâu. Thay vì phụ thuộc vào các trung tâm dữ liệu đám mây tốn kém, các thiết bị trang bị M5 có thể thực thi trực tiếp các mô hình ngôn ngữ lớn (LLM) lên đến hàng chục tỷ tham số ngay trên phần cứng cục bộ.
Tóm tắt thông số cốt lõi
- Quy trình chế tạo: Tiến trình 2nm kết hợp kỹ thuật đóng gói xếp chồng 3D SoIC tiên tiến.
- Băng thông bộ nhớ: Tối ưu hóa kiến trúc bộ nhớ hợp nhất với độ trễ bus cực thấp.
- Năng lực tính toán AI: Đột phá vượt bậc về chỉ số TOPS, hỗ trợ toàn diện AI on-device.
Câu hỏi chuyên sâu (FAQ)
Công nghệ SoIC mang lại ưu thế gì so với CoWoS trước đây?
SoIC cho phép liên kết trực tiếp giữa các die bán dẫn không cần lớp đệm trung gian (interposer), giảm độ trễ và tiết kiệm diện tích đóng gói đáng kể.
Việc đẩy mạnh AI on-device ảnh hưởng ra sao đến thời lượng pin?
Kiến trúc nhân chuyên dụng NPU mới xử lý ma trận hiệu quả hơn, tiêu tốn ít năng lượng hơn nhiều so với việc ép GPU gánh toàn bộ tác vụ AI.