





Sự thâm nhập sâu rộng của các tác nhân trí tuệ nhân tạo (Agentic AI) vào quy trình kỹ nghệ phần mềm đang đặt các nền tảng hạ tầng phát triển toàn cầu vào một phép thử tải trọng khắc nghiệt. Báo cáo kỹ thuật mới nhất ngày 29/10/2026 từ GitHub (công ty thành viên thuộc hệ sinh thái Microsoft) đã phơi bày mức độ tiêu thụ tài nguyên phần cứng khổng lồ đằng sau làn sóng lập trình tự động hóa, buộc các kỹ sư kiến trúc hệ thống phân tán phải tái thiết lập toàn diện các chuẩn mực vận hành trung tâm dữ liệu.
Áp lực phần cứng khổng lồ từ 17,9 tỷ lượt đẩy mã và giải pháp phân tách lưu trữ khỏi điện toán
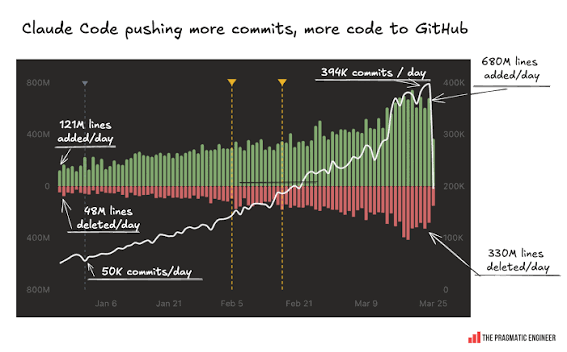
Số liệu thống kê trong năm 2026 xác nhận một bước nhảy vọt phi tuyến tính trong chu kỳ phân phối phần mềm: Lượng commit hàng tháng chạm ngưỡng 7,4 tỷ lượt (tăng trưởng 600% so với cùng kỳ năm trước), trong khi tổng số lần đẩy mã (code pushes) cán mốc 17,9 tỷ. Đáng chú ý, 40% Pull Requests hiện được tự động thực thi bởi các mô hình AI agentic, dẫn tới mật độ tương tác trung bình trên mỗi kho lưu trữ tích hợp AI cao hơn 8 lần so với quy trình thủ công.
Để hấp thụ xung lực tải trọng chưa từng có tiền lệ này, hạ tầng đám mây của GitHub đã phải bổ sung khẩn cấp 4 triệu nhân CPU, 160 Petabytes tài nguyên lưu trữ phân tán và 50 Tbps dung lượng kết nối mạng biên. Thách thức lớn nhất không nằm ở dung lượng lưu trữ tĩnh thuần túy, mà nằm ở băng thông nhập xuất I/O (Input/Output Operations Per Second – IOPS) liên tục. Trước thực trạng này, các kỹ sư GitHub buộc phải tái cấu trúc toàn diện tầng backend, triển khai giải pháp phân tách triệt để giữa tầng lưu trữ dữ liệu (storage layer) và tầng tính toán động (compute layer) nhằm cô lập các cụm tiến trình, ngăn chặn hiện tượng tắc nghẽn tài nguyên diện rộng.
Điểm nghẽn xử lý tự động trong quy trình kiểm thử tích hợp liên tục và rà soát bảo mật
Tác động tiêu cực trực tiếp của làn sóng mã tổng hợp thể hiện rõ nhất tại các đường ống CI/CD (Continuous Integration / Continuous Delivery). Trong mô hình DevSecOps chuẩn mực, mọi thao tác commit đều kích hoạt chuỗi tác vụ tự động bao gồm phân tích mã tĩnh (Static Application Security Testing – SAST), kiểm tra phụ thuộc thư viện mã nguồn mở, biên dịch thử nghiệm và khởi chạy môi trường kiểm thử ảo hóa (containerized integration test suites).
Khi tốc độ sản sinh mã nguồn của các mô hình ngôn ngữ lớn (LLM) vượt xa năng lực xử lý tuần hoàn của hệ thống, chi phí điện toán cho hoạt động kiểm thử tăng vọt theo cấp số nhân. Tình trạng này không chỉ gây lãng phí tài nguyên mà còn làm chậm thời gian phản hồi (feedback loop) của toàn bộ nhóm phát triển. Cảnh báo gần đây từ ban lãnh đạo kỹ thuật Amazon về việc ngăn chặn trào lưu “tokenmaxxing” (lạm dụng hạn mức token AI để giả lập chỉ số hiệu suất lao động) cho thấy các doanh nghiệp công nghệ hàng đầu bắt đầu nhận diện rõ bài toán chi phí biên và độ trễ vận hành khi lạm dụng AI thiếu kiểm soát.
Rủi ro an ninh chuỗi cung ứng phần mềm và bài toán kiểm soát chất lượng mã nguồn tổng hợp
Dưới lăng kính an ninh thông tin, sự bùng nổ của mã nguồn do máy tạo ra đang làm trầm trọng thêm rủi ro an ninh chuỗi cung ứng phần mềm (software supply chain security). Các mô hình AI có xu hướng ảo giác (hallucination) khi gọi các gói thư viện không tồn tại, tạo cơ hội cho tin tặc thực hiện các cuộc tấn công chiếm dụng tên gói (package dependency confusion / typosquatting). Đồng thời, việc thiếu vắng sự thẩm định sâu sắc từ các chuyên gia giàu kinh nghiệm (code review) khiến các lỗ hổng logic phức tạp dễ dàng vượt qua vòng tiền kiểm.
Để bảo đảm tính bền vững của hệ sinh thái công nghệ, các tổ chức phần mềm tương lai sẽ phải chuyển dịch từ mô hình phát triển tập trung vào số lượng sang mô hình quản trị chất lượng nghiêm ngặt. Việc ứng dụng các rào chắn chính sách (policy-as-code), giới hạn tỷ lệ yêu cầu tự động (rate limiting cho AI agents) và chuẩn hóa chỉ số đánh giá giá trị thực chất sẽ là những điều kiện tiên quyết giúp doanh nghiệp tận dụng sức mạnh của AI tạo sinh mà không đánh đổi sự an toàn và độ tin cậy của hạ tầng số quốc gia.