



Một trong những nút thắt kỹ thuật lớn nhất của hệ thống tác tử giọng nói (Voice Agents) nằm ở vòng lặp bốn giai đoạn: Nghe (Transcribe) – Hiểu (Understand) – Quyết định (Decide) – Nói (Synthesize). Toàn bộ chu trình này bắt buộc phải diễn ra gọn gàng trong khoảng thời gian 300 đến 500 mili-giây để người dùng cảm nhận được nhịp đối thoại tự nhiên của con người. Ngày 2/10/2026, nhóm nghiên cứu chuyên trách Microsoft AI đã công bố mô hình nhận dạng tiếng nói dạng luồng MAI-Transcribe-2-Streaming trên Microsoft AI, đồng thời xác lập vị trí dẫn đầu tuyệt đối trên bảng xếp hạng Speech to Text toàn cầu của Artificial Analysis về cả độ chính xác lẫn tốc độ phản hồi.
Tối ưu hóa chu trình tính toán trên đường biên Pareto
Trước đây, các kỹ sư phát triển mô hình nhận dạng tiếng nói (ASR) luôn phải đối mặt với sự đánh đổi nghiệt ngã: nếu muốn độ chính xác cao (tỷ lệ lỗi từ Word Error Rate thấp), mô hình buộc phải gom đủ cụm dữ liệu âm thanh dài và chấp nhận độ trễ lớn; ngược lại, nếu ép độ trễ xuống thấp thì chất lượng phiên âm sẽ giảm sút nghiêm trọng. MAI-Transcribe-2-Streaming đã giải quyết bài toán hóc búa này bằng cách đưa hiệu năng vận hành tiệm cận đường biên tối ưu Pareto (Pareto frontier).
Dữ liệu kiểm chuẩn độc lập từ Artificial Analysis ghi nhận:
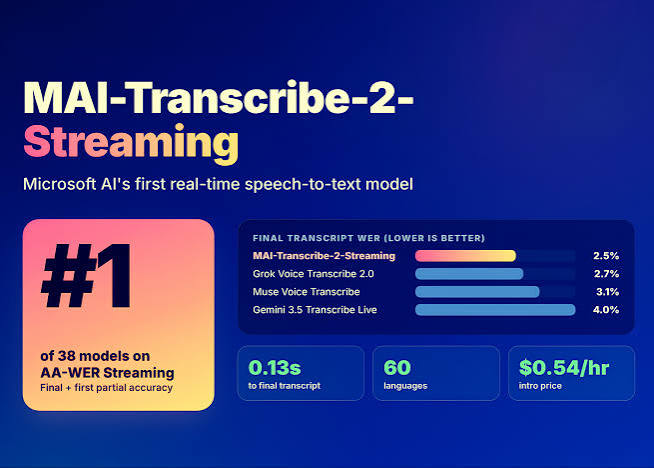
- Thời gian trả về giả thuyết đầu tiên (Time to first partial): Đạt mốc khoảng 120 mili-giây sau khi tiếp nhận tín hiệu âm thanh đầu vào.
- Độ trễ xử lý đầu-cuối (End-to-end latency): Khóa chặt ở mức 128 mili-giây trên toàn bộ quy trình giải mã tín hiệu.
- Tỷ lệ lỗi từ dẫn đầu ngành: Giữ vững vị trí số một về độ chính xác trên cả hai thước đo bản ghi từng phần (partial transcripts) và bản ghi hoàn chỉnh (final transcripts).
Việc nén thời gian phiên âm xuống chỉ còn hơn 100 mili-giây đã “trả lại” phần lớn quỹ thời gian quý giá trong cửa sổ phản hồi tự nhiên, cho phép các mô hình ngôn ngữ lớn (LLM) đằng sau có đủ không gian tính toán để thực hiện các chuỗi suy luận phức tạp (reasoning chains) hoặc gọi các hàm API bên ngoài (tool calling) trước khi trả lời.
Kỹ thuật xử lý ngữ cảnh động và khả năng kích hoạt công cụ giữa câu
Ưu thế kiến trúc nổi bật của MAI-Transcribe-2-Streaming nằm ở đường ống xử lý luồng dữ liệu (streaming pipeline) liên tục sinh ra các giả thuyết từ ngữ (partials). Thay vì đóng băng kết quả tạm thời, thuật toán giải mã liên tục đánh giá lại xác suất chuyển trạng thái của các âm vị trước đó dựa trên luồng âm thanh mới nạp vào, tạo ra cơ chế tự sửa sai động (dynamic context revision).
Khả năng này cho phép các tác tử thông minh thực hiện tác vụ gọi công cụ giữa chừng (mid-sentence tool calling). Ví dụ, trong các dịch vụ hỗ trợ khách hàng, ngay khi người dùng vừa phát âm mã số đơn hàng hoặc tên sản phẩm, tác tử AI đã có thể trích xuất thực thể và gửi lệnh truy vấn cơ sở dữ liệu ngầm, giúp kết quả tìm kiếm sẵn sàng xuất hiện ngay thời điểm người dùng phát âm từ cuối cùng.
Cùng với tính năng tự động nhận diện ngôn ngữ liên tục không cần ngắt phiên trên 60 ngôn ngữ và sự hỗ trợ đồng bộ từ mô hình tổng hợp giọng nói MAI-Voice-2.1-Flash, kiến trúc mới của Microsoft AI đang định hình lại tiêu chuẩn hạ tầng cho thế hệ tác tử giọng nói doanh nghiệp. Chi tiết kỹ thuật và tài liệu mô hình đã được công bố đầy đủ trong báo cáo kỹ thuật.