




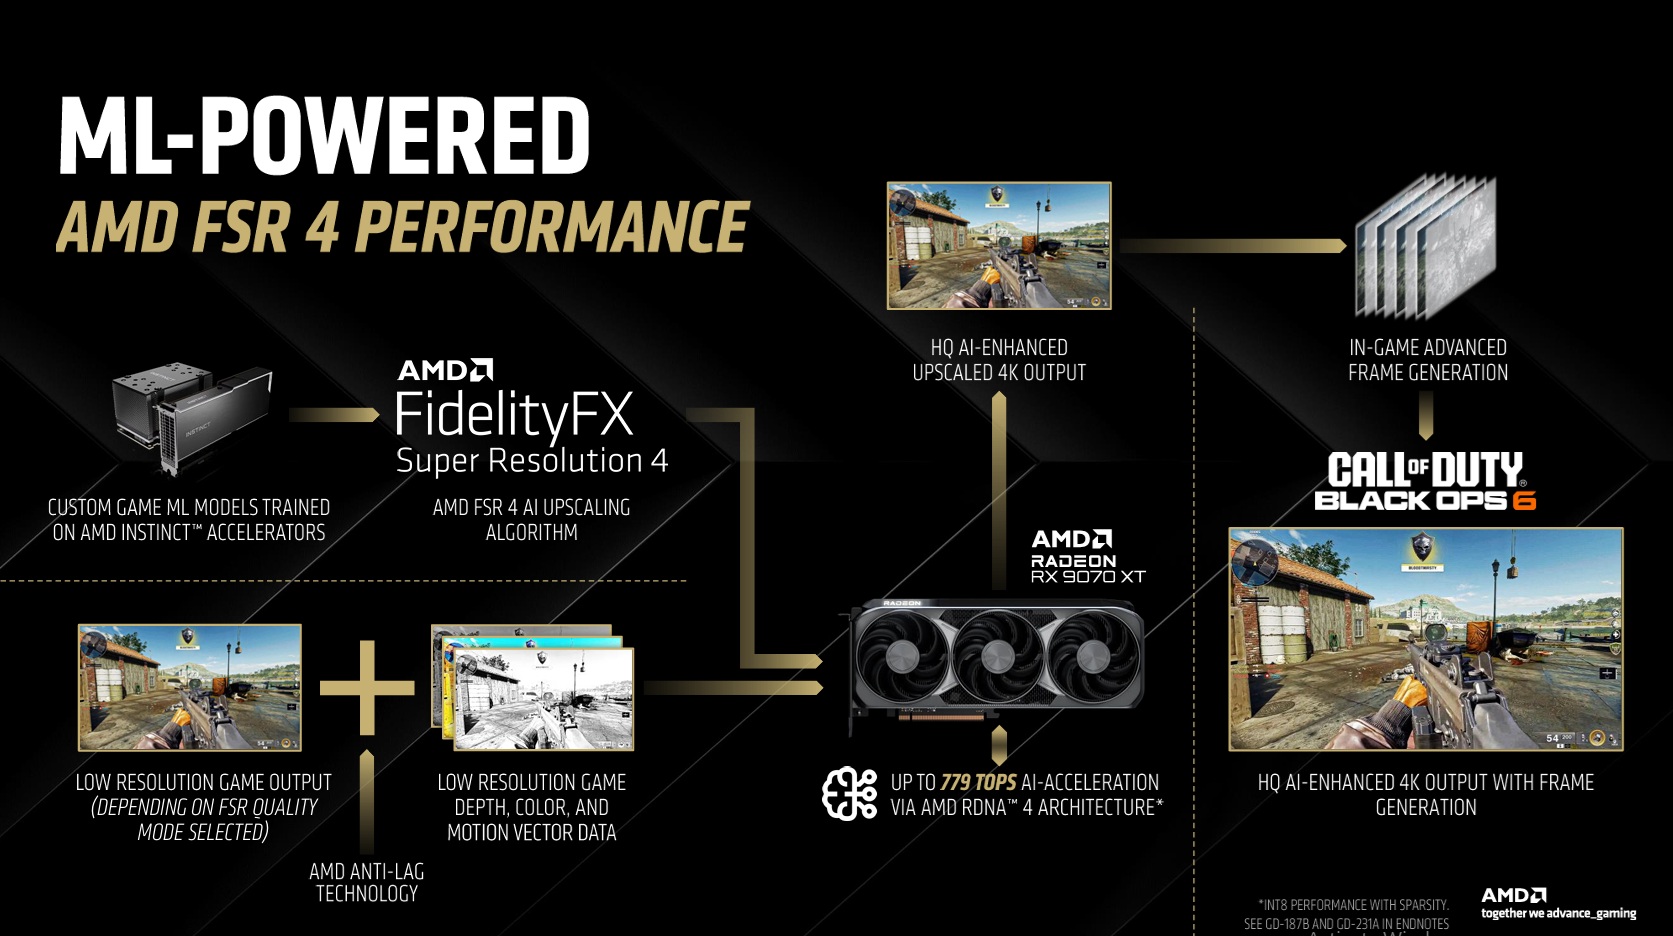
AMD đã chính thức tạo bước chuyển dịch chiến lược mang tính sống còn cho hệ sinh thái đồ họa khi nâng cấp công nghệ FidelityFX Super Resolution lên phiên bản FSR 4 hoàn toàn dựa trên học máy (Fully Machine Learning-based). Quyết định loại bỏ các bộ lọc không gian – thời gian (Spatial-Temporal) thuần toán học để chuyển giao trọng trách xử lý cho mạng nơ-ron nhân tạo đã đưa năng lực tái tạo hình ảnh của AMD bước vào kỷ nguyên điện toán tăng tốc.
Tái cơ cấu đường ống xử lý dữ liệu đồ họa
Trước áp lực cạnh tranh kỹ thuật từ các giải pháp Deep Learning Super Sampling, FSR 4 được thiết kế để vận hành trực tiếp trên các khối tính toán ma trận (Matrix Cores) và bộ tăng tốc NPU tích hợp. Thay vì dựa vào các phỏng đoán heuristics để nội suy vector chuyển động, thuật toán AI mới phân tích luồng đệm hình học (G-buffer), dữ liệu độ sâu và biến thiên màu sắc theo thời gian thực.
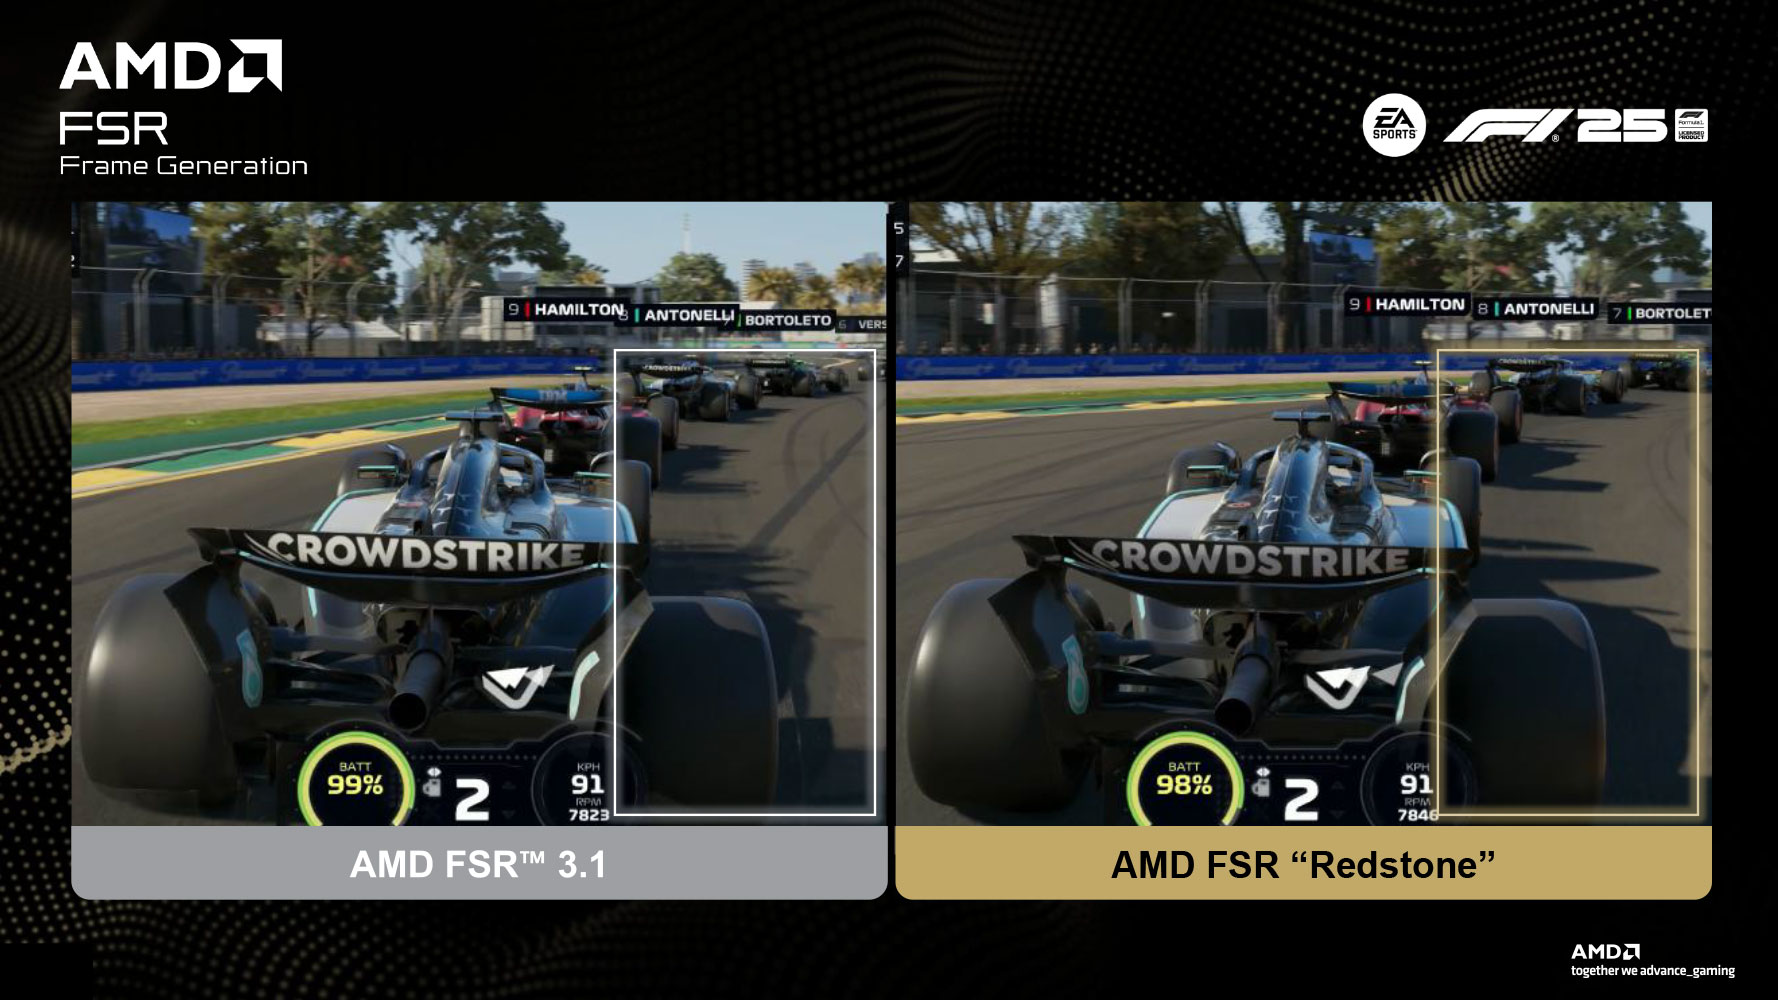
Kết quả mang lại là tính ổn định hình thái học (Temporal Stability) vượt trội. Các vùng chi tiết tần số cao như vân lá cây, lưới kim loại mỏng hoặc hiệu ứng khúc xạ ánh sáng phức tạp không còn bị mất mát thông tin hay phát sinh nhiễu hạt ngẫu nhiên qua từng frame.
Hiệu suất mở rộng và bài toán cân bằng tài nguyên phần cứng
Việc chuyển sang mô hình học sâu đặt ra bài toán tối ưu tài nguyên tính toán giữa shader đồ họa truyền thống và nhân AI chuyên biệt. AMD đã triển khai cơ chế phân phối tải động, giúp quá trình upscale và nội suy khung hình diễn ra song song mà không chiếm dụng băng thông của nhân dựng hình chính (Compute Units).
- Mô hình nơ-ron nén tối ưu: Giảm thiểu bộ nhớ đệm VRAM tiêu hao cho việc lưu trữ trọng số suy luận (inference weights).
- Khử độ trễ phần cứng: Đồng bộ xung nhịp giữa NPU và GPU Engine nhằm rút ngắn frame time xuống dưới ngưỡng cảm nhận của người dùng.
- Độ trung thực tái tạo: Đạt chỉ số PSNR (Peak Signal-to-Noise Ratio) tiệm cận với việc render gốc ở độ phân giải siêu cao.
Đánh giá tổng quan kỹ thuật
FSR 4 khẳng định hướng đi không thể đảo ngược của công nghệ kết xuất đồ họa hiện đại: tận dụng sức mạnh trí tuệ nhân tạo để giải phóng năng lực tính toán thô của phần cứng bán dẫn.
FAQ – Góc phân tích kỹ thuật
Mô hình Machine Learning của FSR 4 có đòi hỏi phần cứng chuyên biệt không?
Thuật toán FSR 4 được tối ưu hóa sâu cho tập lệnh tăng tốc ma trận, do đó hiệu năng tối đa sẽ đạt được trên các dòng kiến trúc GPU và APU sở hữu đơn vị tính toán AI chuyên dụng.