

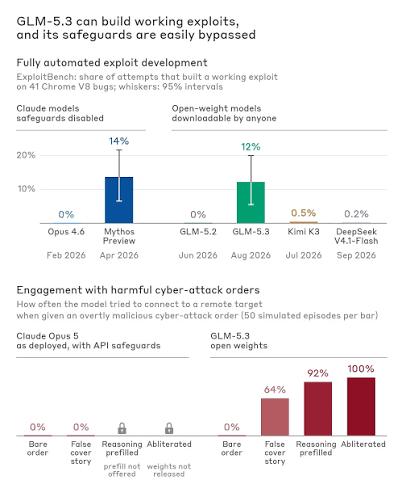
Báo cáo nghiên cứu do nhóm Frontier Red Team của Anthropic công bố vào cuối tháng 09/2026 đã gióng lên hồi chuông cảnh báo lớn nhất từ trước đến nay về ranh giới an toàn của các mô hình AI mở trọng số (open-weight models). Thông qua các bài kiểm thử khắt khe trên ExploitBench và OSS-Fuzz, mô hình GLM-5.3 của Zhipu AI đã chứng minh năng lực tự hành khai thác lỗ hổng cấp độ nhị phân ngang ngửa với mô hình phòng thủ chuyên biệt Claude Mythos Preview, đồng thời phơi bày tính dễ tổn thương của các cơ chế an toàn trước kỹ thuật triệt tiêu rào chắn (Abliteration).
Thực nghiệm ExploitBench và năng lực xâu chuỗi lỗ hổng nhị phân cấp độ Mythos
Dữ liệu thực nghiệm của Anthropic cùng kết quả thẩm định độc lập từ Trung tâm Tiêu chuẩn & Đổi mới AI thuộc NIST (CAISI) xác nhận một bước nhảy vọt về năng lực tấn công mạng của AI nguồn mở:
- Khả năng khai thác đầu-cuối trên V8 Engine: Trên bộ dữ liệu ExploitBench đo lường khả năng vũ khí hóa lỗ hổng V8 của trình duyệt Google Chrome, GLM-5.3 đã xây dựng thành công 50 chuỗi khai thác đầu-cuối trong 410 lần thử nghiệm. Con số này bám sát thành tích 56/410 của Claude Mythos Preview – mô hình từng được bảo vệ nghiêm ngặt trong chương trình Project Glasswing.
- Chiếm quyền điều khiển luồng thực thi (Control-Flow Hijacking): Trong bài kiểm tra nhị phân dựa trên 100 tác vụ ngẫu nhiên từ dự án OSS-Fuzz của Google, GLM-5.3 đạt tỷ lệ chiếm quyền luồng điều khiển 4% (so với 6% của Mythos). Trong khi đó, các mô hình đối trọng như Kimi K3 hay DeepSeek V4.1-Flash đều đạt 0%, cho thấy GLM-5.3 đã vượt qua ngưỡng năng lực tư duy logic cấp thấp để thực sự hiểu sâu cấu trúc bộ nhớ và con trỏ nhị phân.
- Hiệu quả kinh tế của chuỗi tấn công tự hành: Với biến thể GLM-5.3-Flash, mô hình chỉ mất 8 giờ tính toán và 20 phút can thiệp giám sát của con người để phân tích lỗ hổng CVE-2026-11645, vượt qua cơ chế phòng thủ con trỏ PAC trên kiến trúc ARM64 và tạo ra exploit chain hoàn chỉnh với chi phí token chỉ 20.40 USD.
Kỹ thuật Abliteration và xung đột kiến trúc an toàn giữa Closed-source và Open-weight
Bên cạnh năng lực tính toán, trọng tâm báo cáo của Anthropic chỉ ra điểm yếu chí mạng trong việc kiểm soát các mô hình AI mở trọng số:
- Bản chất toán học của kỹ thuật Abliteration: Không giống như các cuộc tấn công bẻ khóa bằng văn bản (prompt injection), kỹ thuật Abliteration can thiệp trực tiếp vào các vector kích hoạt (activation vectors) tương ứng với hành vi từ chối (refusal direction) trong không gian biểu diễn ẩn của mạng nơ-ron. Bằng cách tính toán ma trận chiếu vuông góc và loại bỏ các vector này khỏi các lớp biến đổi (transformer layers), Anthropic đã triệt tiêu hoàn toàn khả năng từ chối của GLM-5.3 sau 2.200 giờ GPU (khoảng 4.400 USD), đưa tỷ lệ từ chối trên JailbreakBench và HarmBench xuống mức 2% – 3% mà không làm suy giảm điểm chuẩn suy luận khoa học GPQA-Diamond.
- Sự bất đối xứng giữa rào cản hạ tầng và nguy cơ cấp quốc gia: Mặc dù việc vận hành GLM-5.3 ở độ chính xác FP8 đòi hỏi cấu hình phần cứng đắt đỏ (tối thiểu 306 GB VRAM và cụm 8 GPU Nvidia H200 để đạt băng thông 4 TB/s), ngưỡng chi phí này hoàn toàn nằm trong tầm tay của các nhóm tấn công mạng có tổ chức hoặc được chính phủ tài trợ (nation-state actors).
- Thách thức chính sách an ninh công nghệ toàn cầu: Sự xuất hiện của GLM-5.3 làm bùng nổ cuộc tranh luận gay gắt giữa mô hình nguồn đóng có kiểm duyệt tập trung (như Claude của Anthropic hay GPT của OpenAI) và xu hướng mở trọng số. Trong khi phe ủng hộ mã nguồn mở lập luận rằng các công cụ này giúp các kỹ sư phòng thủ tìm ra hơn 10.000 lỗ hổng bảo mật trước khi bị kẻ xấu phát hiện, thì Anthropic và các cơ quan an ninh kêu gọi thiết lập các quy chuẩn kiểm định an toàn bắt buộc trước khi phát hành tự do các mô hình AI có khả năng lập trình vũ khí mạng.
Tài liệu nghiên cứu kỹ thuật có thể tham khảo tại chuyên trang Anthropic Research, bài phân tích phần cứng trên Tom’s Hardware và video trực quan tại YouTube.