

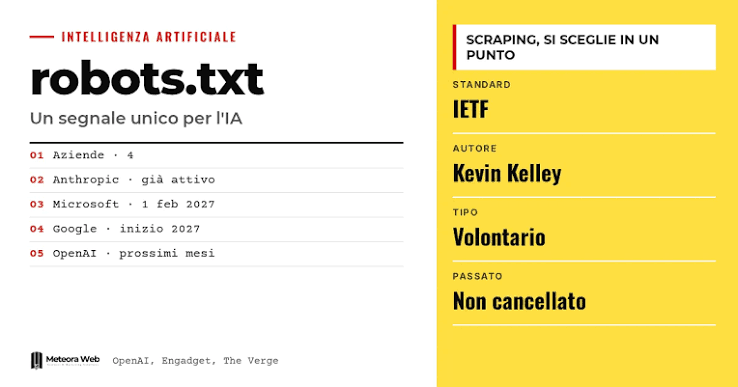
Thỏa thuận chung giữa bốn tập đoàn công nghệ dẫn đầu lĩnh vực trí tuệ nhân tạo – OpenAI, Google, Microsoft và Anthropic – về việc cam kết tôn trọng một token chính sách duy nhất mang tên __usage_ai-training trong tệp robots.txt đánh dấu bước chuyển mình mang tính cấu trúc trong việc quản trị dữ liệu web. Bằng cách dịch chuyển từ cơ chế nhận diện định danh bot phân mảnh (per-crawler identifier) sang cơ chế kiểm soát dựa trên mục đích sử dụng (purpose-based signaling), ngành công nghiệp AI đang từng bước chuẩn hóa quyền tự quyết dữ liệu cho các nhà xuất bản nội dung số.
Cơ sở kỹ thuật từ dự thảo chuẩn hóa AIPREF của IETF
Tiêu chuẩn mới không bắt nguồn từ một giải pháp cục bộ của riêng doanh nghiệp nào, mà được xây dựng dựa trên dự thảo nghiên cứu của nhóm công tác AI Preferences (AIPREF) trực thuộc tổ chức tiêu chuẩn hóa Internet IETF do kỹ sư Kevin Kelley thuộc Anthropic chủ trì. Về mặt kỹ thuật, giải pháp này tận dụng hoàn toàn cấu trúc cú pháp quen thuộc của tệp robots.txt đã được chuẩn hóa theo tiêu chuẩn RFC 9309 mà không làm phát sinh các giao thức kết nối phức tạp.
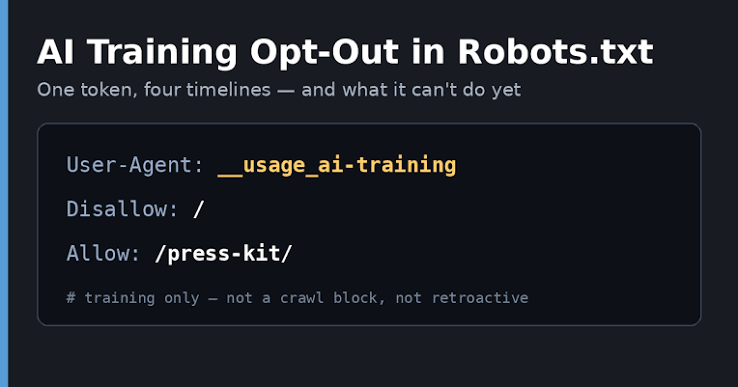
Khi quản trị viên khai báo cú pháp:
User-Agent: __usage_ai-training
Disallow: /
Hệ thống sẽ gắn cờ toàn bộ hoặc một phần không gian URL của website với định nghĩa “AI Training” đã được quy chuẩn hóa trong tài liệu kỹ thuật draft-ietf-aipref-vocab. Cách tiếp cận này giúp chính sách từ chối (opt-out) duy trì tính bền vững lâu dài, bởi nó định nghĩa hành vi xử lý dữ liệu thay vì tên gọi biến đổi liên tục của các tác nhân phần mềm (User-Agent strings) trong tương lai.
Phân định ranh giới giữa AI Training và Retrieval Grounding
Một khía cạnh kỹ thuật then chốt mà giới phân tích đặc biệt lưu tâm là ranh giới tác động của token mới. Theo cam kết được công bố, __usage_ai-training chỉ có hiệu lực điều chỉnh quá trình huấn luyện mô hình nền tảng (pre-training và fine-tuning) – tức hành vi cập nhật trọng số tham số mạng nơ-ron bằng dữ liệu văn bản.
Ngược lại, token này hoàn toàn không can thiệp vào quá trình thu thập thông tin thời gian thực phục vụ việc trả lời câu hỏi trực tiếp (Retrieval-Augmented Generation – RAG) hoặc công nghệ đối chiếu ngữ cảnh (grounding). Điển hình như Google đã làm rõ rằng token này tương đương với chỉ thị chặn của Google-Extended dành cho việc đào tạo mô hình Gemini, nhưng các tính năng như AI Overviews hay AI Mode trong công cụ tìm kiếm vẫn chịu sự quản lý riêng biệt qua Search Console. Tương tự, Microsoft cũng phát triển song song các thẻ meta tag cấp độ trang để phân định quyền trích xuất dữ liệu trong Bing Webmaster Tools.
Lộ trình chuyển tiếp và những khoảng trống chính sách còn lại
Mặc dù mang ý nghĩa bước ngoặt, tính hiệu lực thực tế của chuẩn __usage_ai-training sẽ cần thời gian để đi vào đời sống mạng. Anthropic là đơn vị tiên phong đã bắt đầu triển khai hệ thống nhận diện này. Microsoft đã ấn định thời điểm áp dụng từ ngày 01/02/2027, trong khi Google đặt mục tiêu vào đầu năm 2027 và OpenAI cam kết hoàn thiện trong các bản phát hành sắp tới.
Khoảng trống lớn nhất của thỏa thuận hiện nay là sự vắng mặt của các thế lực đào tạo mô hình lớn khác như Meta, Apple hay Amazon. Do robots.txt về bản chất là một quy ước kỹ thuật tự nguyện thiếu chế tài cưỡng chế pháp lý bắt buộc, việc bảo vệ toàn diện tài sản trí tuệ của các tổ chức xuất bản số vẫn đòi hỏi sự phối hợp đa tầng: kết hợp giữa tín hiệu chỉ thị robots.txt, các biện pháp giới hạn tần suất truy cập máy chủ (rate-limiting) và các thỏa thuận thương mại cấp phép dữ liệu song phương có ràng buộc pháp lý.