




Báo cáo thử nghiệm phần cứng do Tom’s Hardware công bố ngày 28/09/2026 đã ghi nhận một cột mốc công nghệ đáng chú ý: dự án mã nguồn mở DLSS-NR-on-AMD của lập trình viên Daniel Blanco cùng nhóm phát triển AMD-NR—OptiScaler đã hiện thực hóa việc vận hành công nghệ đồ họa AI thế hệ mới DLSS 5 Neural Rendering trên kiến trúc GPU AMD RDNA 4 và RDNA 3. Thành tựu này không dựa trên các giải pháp giả lập tầng ứng dụng mà xuất phát từ việc tái cấu trúc toàn diện môi trường thực thi mạng nơ-ron trên tập lệnh phần cứng của AMD.
Kiến trúc HIP kernels và giải pháp phân tầng kích thước mạng nơ-ron
Trở ngại lớn nhất của công nghệ Neural Rendering nằm ở khối lượng tính toán ma trận khổng lồ, vốn được NVIDIA thiết kế tối ưu riêng cho các nhân Tensor Cores độc quyền trên kiến trúc Blackwell. Để vượt qua rào cản này mà không vi phạm sở hữu trí tuệ, tác giả Daniel Blanco đã viết lại từ đầu toàn bộ neural runtime bằng ngôn ngữ HIP (Heterogeneous-compute Interface for Portability), biên dịch các kernel tính toán trực tiếp cho cấu trúc Compute Units (CU) của AMD mà không sử dụng bất kỳ dòng mã hay thư viện chuyển đổi thời gian thực nào từ NVIDIA.
Nhằm giải quyết độ trễ xử lý (network latency), phiên bản mới nhất Alpha 0.4.0 và biến thể OptiScaler 0.3.4.2 đã áp dụng hàng loạt giải pháp kỹ thuật tinh vi:
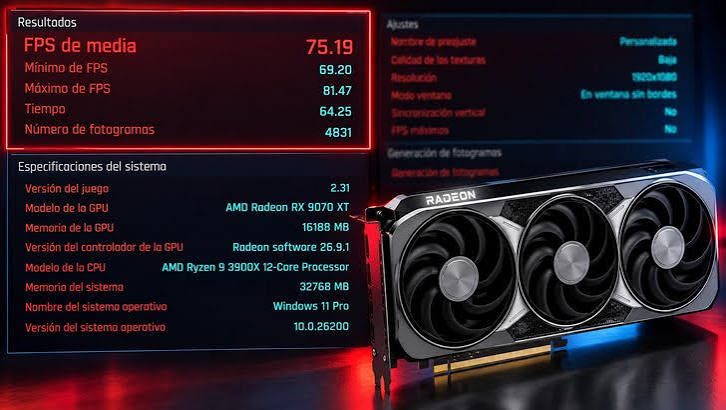
- Cơ chế phân tầng kích thước mạng (Network Size Tiers): Thay vì xử lý mạng nơ-ron ở toàn bộ độ phân giải khung hình gốc, hệ thống chia mạng thành các tầng cố định gồm 720p (1280×720), 900p (1600×900) và 1080p (1920×1080). Trên các dòng card RDNA 3 như RX 7800 XT, thuật toán tự động co cụm độ phân giải đầu vào về tầng gần nhất, giảm thời gian tính toán của một lượt quét mạng từ 73.3 ms xuống 52.2 ms.
- Lồng ghép mô hình nơ-ron cách khung (Model Interleave): Tác vụ suy luận nơ-ron không chạy liên tục trên từng khung hình mà được thực hiện cách khung (chạy mỗi 2 hoặc 4 khung hình một lần). Các khung hình trung gian được bù đắp thông qua vector chuyển động (motion vectors) và cơ chế tổng hợp phần dư (residual composition), giúp giải phóng đáng kể băng thông cho các nhân đồ họa xử lý rasterization truyền thống.
Mở rộng tiềm năng sang thiết bị cầm tay và phá vỡ rào cản độc quyền công nghệ
Một bước đột phá khác trong bản cập nhật là khả năng tương thích bước đầu với các bộ xử lý di động APU kiến trúc RDNA 3 như Ryzen Z1 Extreme, Z2 Extreme trên các máy chơi game cầm tay (ROG Ally). Dù mức tiêu tốn tài nguyên vẫn còn cao, việc chạy được mạng nơ-ron ở tầng 360p cho thấy tính khả thi của mô hình xử lý phân tán.
Bên cạnh đó, việc tích hợp sâu vào khung OptiScaler và giao diện DirectX 12 hook cho phép bản mod tương thích tự nhiên với bất kỳ tựa game nào hỗ trợ AMD FSR, cho phép người dùng kích hoạt đồng thời FSR Ray Regeneration và các công nghệ tạo khung hình (frame generation). Sự bùng nổ của dự án DLSS-NR-on-AMD là minh chứng rõ nét cho thấy ranh giới phần cứng độc quyền trong kỷ nguyên xử lý đồ họa nơ-ron hoàn toàn có thể bị phá vỡ bởi các giải pháp kỹ thuật đảo ngược và tối ưu hóa mã nguồn mở.
Dữ liệu benchmark và mã nguồn chi tiết hiện được công khai trên GitHub DLSS-NR-on-AMD và GitHub AMD-NR—OptiScaler.